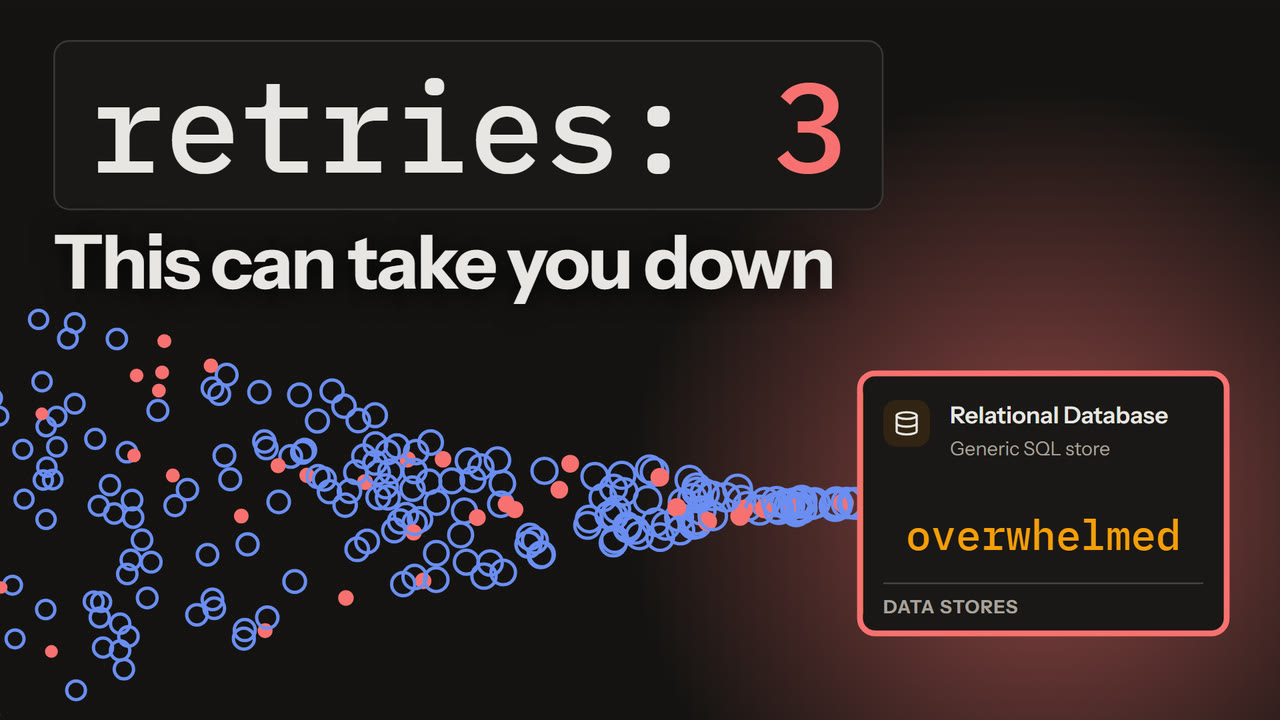
Retry é a primeira coisa que qualquer pessoa coloca em um cliente, e em geral é a coisa certa. Um pacote foi perdido, um nó foi trocado no meio da requisição, uma conexão foi resetada: tentar de novo custa quase nada e transforma um erro visível em um soluço que ninguém percebe, desde que a operação seja segura de repetir (idempotente, ou deduplicada pelo servidor).
Esse raciocínio vale para um único modo de falha: o transitório, em que a segunda tentativa provavelmente cai em um sistema saudável. Quando o erro é saturação, a segunda tentativa cai no mesmo componente sobrecarregado, e chega como trabalho extra.
A multiplicação que ninguém planejou
Um cliente configurado para três tentativas (a primeira e até dois retries) transforma uma requisição em até três. Quando uma dependência começa a falhar sob carga, isso não é 3% a mais de tráfego: é até 3x, aplicado exatamente quando a dependência tem menos condições de absorver isso.
Piora com a profundidade. Retries em mais de uma camada se multiplicam em vez de se somar: um gateway que faz três tentativas em um serviço, o qual faz três tentativas no banco de dados a cada chamada, pode colocar nove tentativas no banco de dados. Ninguém escreveu 9 em lugar nenhum. É o produto de duas configurações independentes, cada uma razoável quando vista isoladamente.
- Faça retry em uma camada só, em geral a mais externa que ainda consegue ser útil.
- Um orçamento de retries: deixe os retries gastarem tokens que só as requisições originais ganham, uma fração de token cada, para que os retries continuem sendo uma fração pequena do tráfego e o multiplicador tenha um teto, por pior que a situação fique.
- Um circuit breaker, para que uma dependência que falha de forma consistente deixe de ser chamada por um tempo, em vez de ser consultada de novo por todo mundo.
Backoff é necessário, mas não suficiente
O backoff exponencial espalha as tentativas no tempo, e isso alivia de verdade. Mas ele não reduz o número total de tentativas: só as adia. Se a dependência continuar fora do ar durante toda a janela de backoff, o mesmo volume chega um pouco depois, e chega sincronizado: todo cliente que falhou no mesmo instante espera o mesmo intervalo e volta junto.
A parte que sobrevive à queda
O motivo de a tempestade de retries merecer nome próprio é que ela não termina quando o problema original termina. A dependência se recupera, encontra os retries acumulados de todos que falharam enquanto ela estava fora, satura de novo e produz a rodada seguinte. O gatilho sumiu e o sistema continua no chão.
Esse é o padrão a procurar em um postmortem: um incidente que dura bem mais que a sua causa.
Vendo isso em um diagrama
Em um canvas do RodGrid, o preset de estresse Tempestade de retries acrescenta uma taxa de erro aos nós de serviço e dá a cada requisição que falha até três retries (quatro tentativas), e então calcula o tráfego que esses retries somam: as duas metades que formam a falha, aplicadas juntas. O que você procura não é se um componente fica vermelho, e sim qual fica sem capacidade sob a carga multiplicada, e se os componentes atrás dele foram dimensionados para o número multiplicado ou para o original.