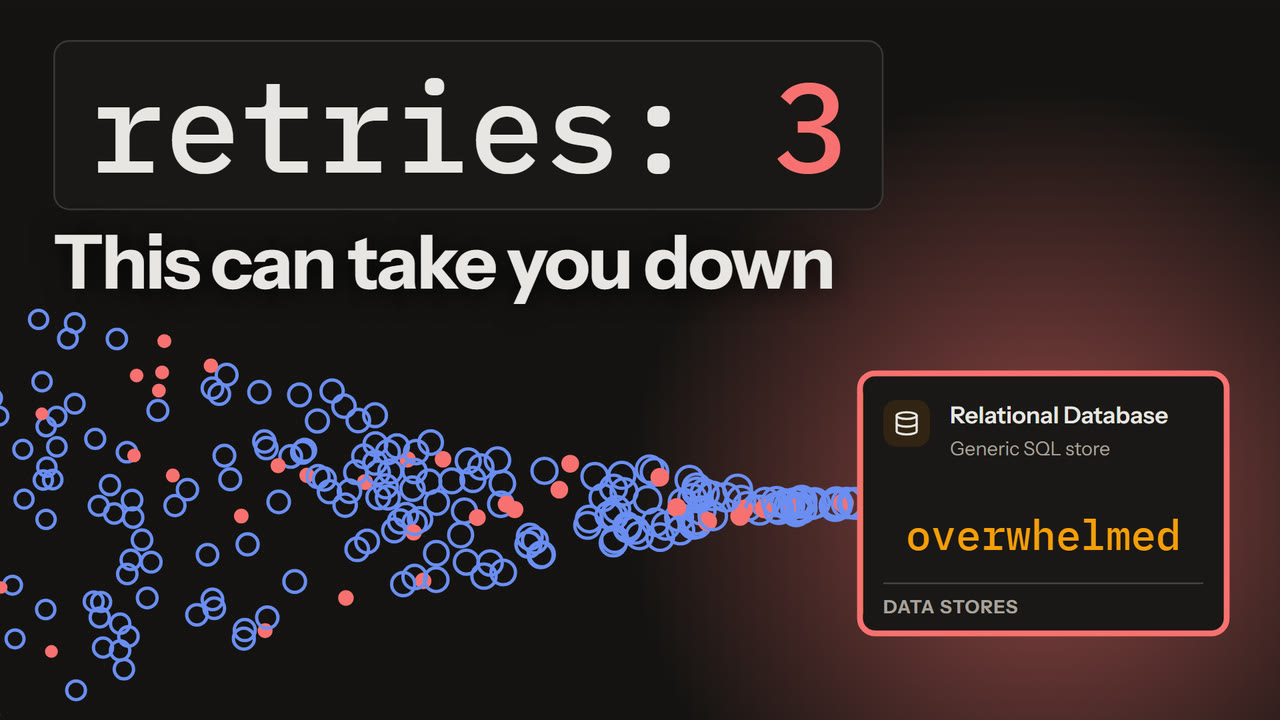
El reintento es lo primero que cualquiera añade a un cliente, y normalmente es lo correcto. Se perdió un paquete, se reemplazó un nodo a mitad de solicitud, se reinició una conexión: volver a intentarlo casi no cuesta nada y convierte un error visible en un contratiempo que nadie nota, siempre que la operación sea segura de repetir (idempotente, o deduplicada por el servidor).
Ese razonamiento vale para un solo modo de fallo: el transitorio, en el que el segundo intento probablemente caiga en un sistema sano. Cuando el error es saturación, el segundo intento cae en el mismo componente sobrecargado, y llega como trabajo extra.
La multiplicación que nadie planeó
Un cliente configurado con tres intentos (el primero y hasta dos reintentos) convierte una solicitud en hasta tres. Cuando una dependencia empieza a fallar bajo carga, eso no es un 3% más de tráfico: es hasta 3×, aplicado justo cuando la dependencia es menos capaz de absorberlo.
Empeora con la profundidad. Los reintentos en más de una capa se multiplican en lugar de sumarse: un gateway que hace tres intentos contra un servicio, que a su vez hace tres intentos contra la base de datos en cada llamada, puede poner nueve intentos sobre la base de datos. Nadie escribió un 9 en ninguna parte. Es el producto de dos configuraciones independientes y razonables por separado.
- Reintenta en una sola capa, normalmente la más externa que todavía pueda ser útil.
- Un presupuesto de reintentos (retry budget): haz que los reintentos gasten tokens que solo ganan las solicitudes originales, una fracción de token cada uno, de modo que los reintentos sigan siendo una pequeña fracción del tráfico y el multiplicador tenga un techo por mal que vaya todo.
- Un circuit breaker, para que una dependencia que falla de forma constante deje de recibir llamadas durante un tiempo en lugar de que todos vuelvan a llamarla.
El backoff es necesario, pero no suficiente
El backoff exponencial reparte los intentos en el tiempo, lo cual es un alivio real. Pero no reduce el número total de intentos: los retrasa. Si la dependencia sigue caída durante toda la ventana del backoff, el mismo volumen llega un poco más tarde, y llega sincronizado: todos los clientes que fallaron en el mismo momento esperan el mismo intervalo y vuelven juntos.
La parte que sobrevive a la caída
La razón por la que una tormenta de reintentos merece un nombre propio es que no termina cuando termina el problema original. La dependencia se recupera, se encuentra con los reintentos acumulados de todos los que fallaron mientras estuvo caída, se satura otra vez y produce la siguiente ronda. El detonante ya no está y el sistema sigue en el suelo.
Esta es la forma que hay que buscar en un postmortem: un incidente que dura mucho más que su causa.
Verlo en un diagrama
En un lienzo de RodGrid, el preset de estrés Tormenta de reintentos añade una tasa de error a los nodos de servicio y da a cada solicitud fallida hasta tres reintentos (cuatro intentos), y luego calcula el tráfico que esos reintentos añaden: las dos mitades que componen el fallo, aplicadas juntas. Lo que hay que buscar no es si un componente se pone en rojo, sino cuál se queda sin capacidad bajo la carga multiplicada, y si los componentes que tiene detrás se dimensionaron para el número multiplicado o para el original.