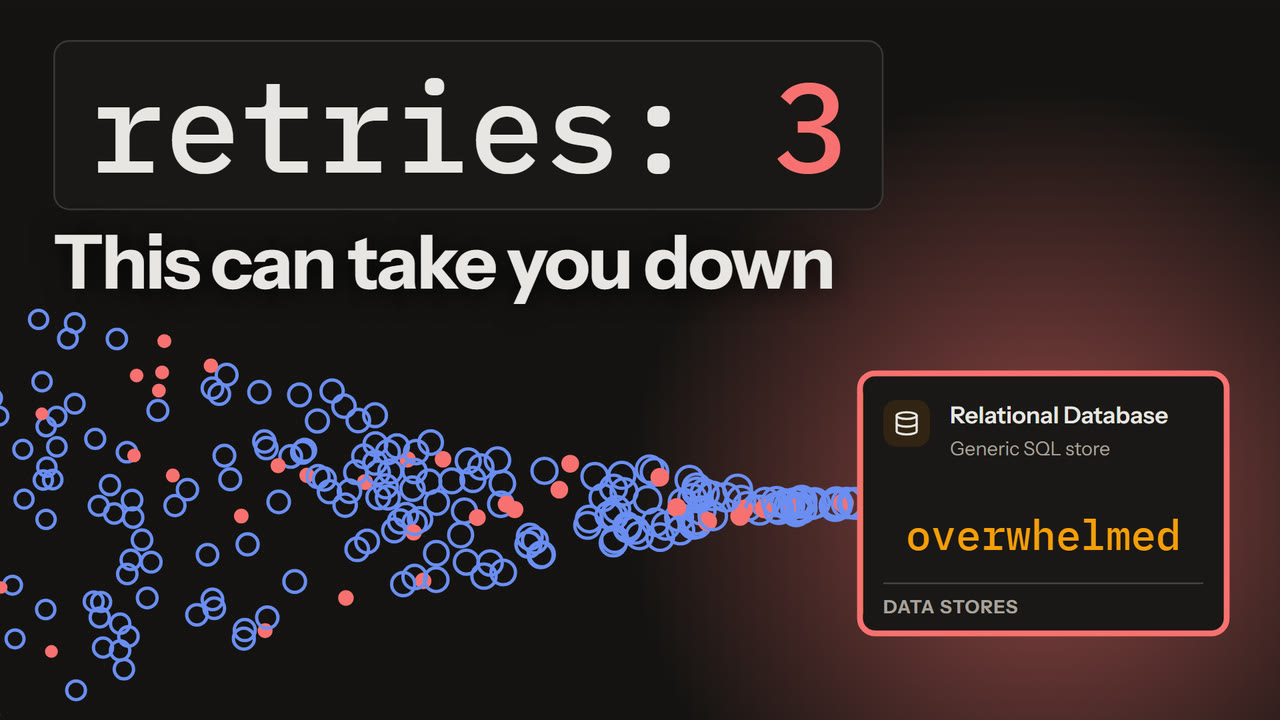
Retry ist das Erste, was jeder in einen Client einbaut, und meist das Richtige. Ein Paket wurde verworfen, ein Knoten mitten im Request ausgetauscht, eine Verbindung zurückgesetzt – es noch einmal zu versuchen kostet fast nichts und macht aus einem sichtbaren Fehler einen Schluckauf, den niemand bemerkt, vorausgesetzt, die Operation lässt sich gefahrlos wiederholen (idempotent oder vom Server dedupliziert).
Diese Überlegung gilt nur für einen Fehlermodus: den vorübergehenden, bei dem der zweite Versuch wahrscheinlich ein gesundes System trifft. Ist der Fehler stattdessen Überlastung, trifft der zweite Versuch dieselbe überlastete Komponente – und kommt als zusätzliche Arbeit an.
Die Vervielfachung, die niemand geplant hat
Ein Client, der auf drei Versuche konfiguriert ist – den ersten und bis zu zwei Retries –, macht aus einem Request bis zu drei. Wenn eine Abhängigkeit unter Last zu scheitern beginnt, sind das keine 3% mehr Traffic, sondern bis zum Dreifachen, genau dann, wenn die Abhängigkeit es am schlechtesten auffangen kann.
Mit der Tiefe wird es schlimmer. Retries auf mehreren Ebenen multiplizieren sich, statt sich zu addieren: Ein Gateway, das es bei einem Dienst dreimal versucht, der es wiederum bei jedem Aufruf dreimal bei der Datenbank versucht, kann neun Versuche auf die Datenbank legen. Nirgends hat jemand 9 hingeschrieben. Es ist das Produkt aus zwei unabhängigen, für sich vernünftigen Einstellungen.
- Retry auf einer einzigen Ebene, meist der äußersten, auf der er noch etwas nützt.
- Ein Retry-Budget – Retries verbrauchen Tokens, die nur ursprüngliche Requests verdienen, jeweils einen Bruchteil eines Tokens, sodass Retries ein kleiner Anteil des Traffics bleiben und der Multiplikator eine Obergrenze hat, egal wie schlimm es wird.
- Ein Circuit Breaker, damit eine Abhängigkeit, die dauerhaft scheitert, eine Weile nicht mehr aufgerufen wird, statt von allen erneut gefragt zu werden.
Backoff ist nötig, aber nicht ausreichend
Exponentielles Backoff verteilt die Versuche über die Zeit, und das ist eine echte Entlastung. Es verringert aber nicht die Gesamtzahl der Versuche – es verzögert sie. Bleibt die Abhängigkeit für die Länge des Backoff-Fensters ausgefallen, kommt dasselbe Volumen etwas später an, und zwar synchronisiert: Alle Clients, die im selben Moment gescheitert sind, warten dasselbe Intervall und kommen gemeinsam zurück.
Der Teil, der den Ausfall überlebt
Ein Retry-Sturm verdient einen eigenen Namen, weil er nicht endet, wenn das ursprüngliche Problem endet. Die Abhängigkeit erholt sich, findet die aufgelaufenen Retries aller vor, die während des Ausfalls gescheitert sind, läuft wieder voll und erzeugt die nächste Runde. Der Auslöser ist weg, und das System liegt immer noch am Boden.
Das ist die Form, nach der du in einem Postmortem suchen solltest: ein Incident, der deutlich über das Ende seiner Ursache hinaus andauert.
Im Diagramm beobachten
Auf einem RodGrid-Canvas fügt das Stress-Preset Retry-Sturm den Service-Knoten eine Fehlerrate hinzu und gibt jedem fehlgeschlagenen Request bis zu drei Retries (vier Versuche), und berechnet dann den Traffic, den diese Retries zusätzlich erzeugen – die zwei Hälften, die den Ausfall ausmachen, gemeinsam angewendet. Du suchst nicht danach, ob eine Komponente rot wird, sondern danach, welcher unter der vervielfachten Last die Kapazität ausgeht und ob die Komponenten dahinter für die vervielfachte Zahl dimensioniert waren oder für die ursprüngliche.